中美AI爭霸 鬥平亦鬥表現︳封面故事


Tokenomics。事實上,Token是大語言模型處理資訊的最小單位,也是AI服務的計價單位。Token的價格高低與消耗量,正影響著用戶的使用成本。隨之而來的關鍵問題,究竟Token是如何定價?未來Token定價權又會掌握在誰人手裏?下文將會循這兩個問題出發,介紹Token經濟的最新發展。
Token是自然語言處理(NLP)中用於表示文字的基本單位,亦可以被理解為大語言模型處理資訊的最小單位。Token可以是詞、字元,或按照其他規則切割的字串片段。
而將文字切割成Token的過程,就是字元化(Tokenization)。AI要處理用戶輸入的提示詞(Prompt),必須經過字元化過程,然後再送往系統處理。
Token售價4年跌9成
以OpenAI為例,一個Token約等於四個字元,亦等於四分之三個英文單字。而每100個
Token大約等於75個英文單字。OpenAI並沒有提供一個Token包括多少個中文字的數據,不過,一般而言,每個Token大約代表0.5至1.8個中文字。換言之,每個中文字須要耗用0.6個至兩個Token。
由此可見,Token是AI經濟中處理資訊的最小單位,亦身兼AI用戶使用付費服務的單位計價的功能。
除月費計劃外,AI前沿實驗室透過以應用程式介面(API)形式提供AI服務,其收費以「每百萬個Token收多少錢」為基準,按用戶實際用量收取費用。
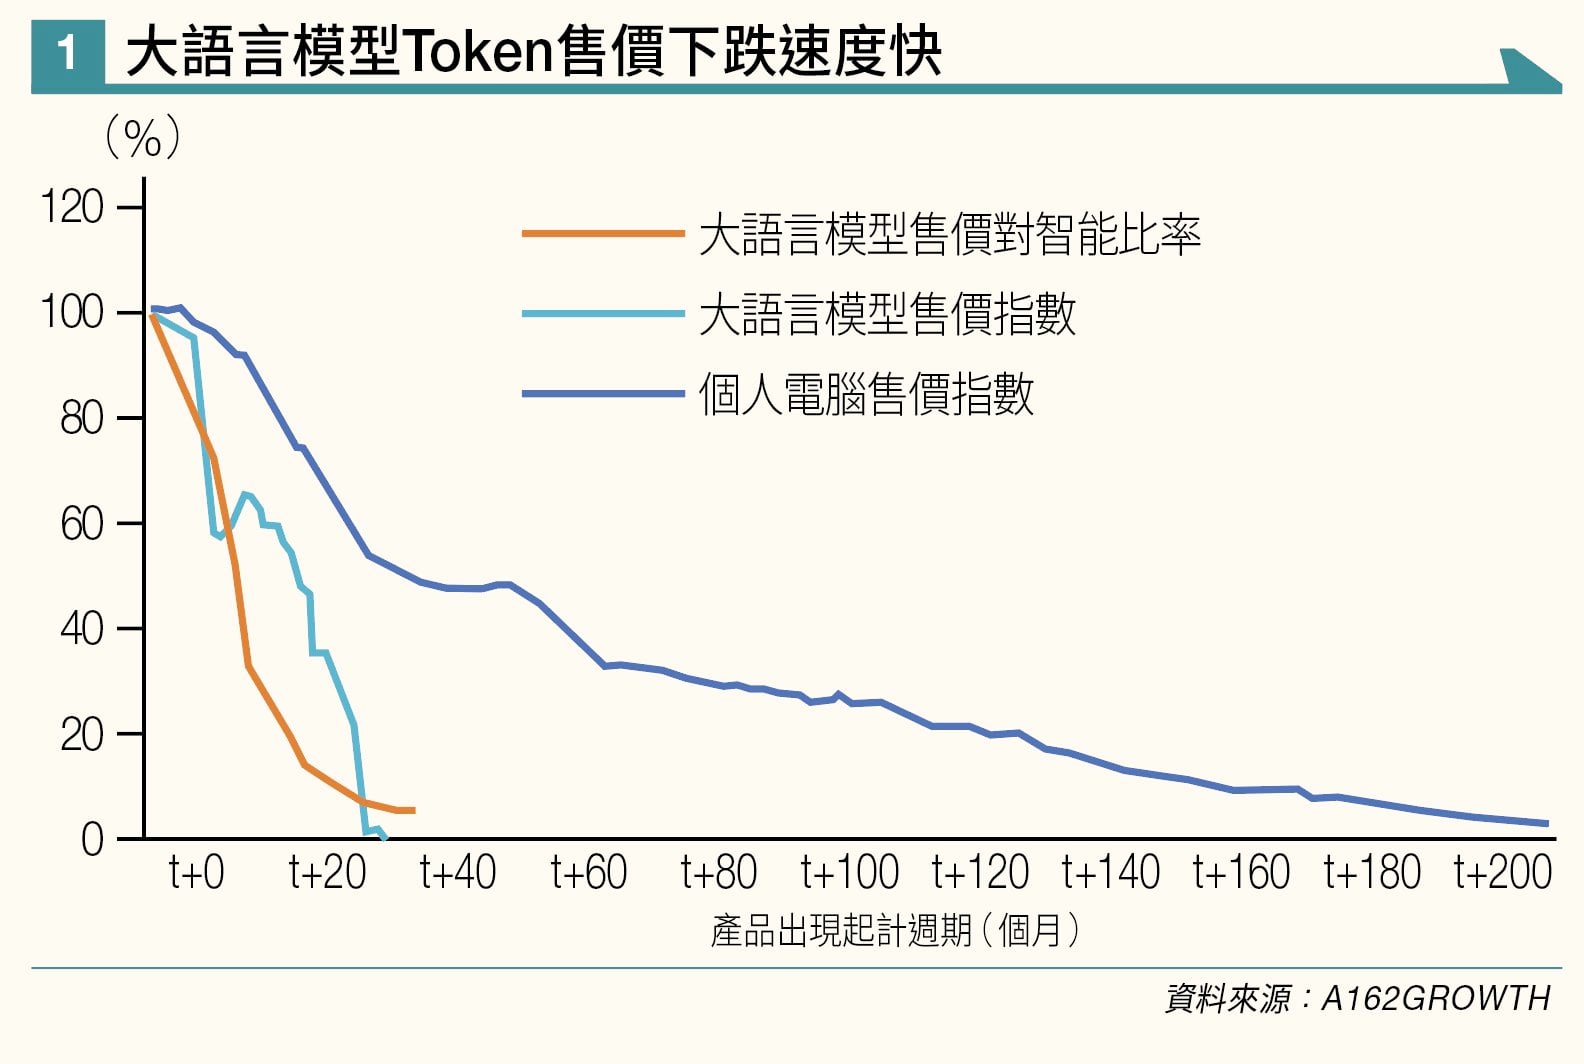
由2022年11月至今,AI世代經歷超過三年實戰。由美國矽谷風險創投公司a16z編制的圖表,顯示一個極為有趣的現象,就是大語言模型Token售價,竟然在不足四年間下跌90%(見圖一)。
大語言模型出現通縮
有些產品售價只會愈出愈便宜,例如個人電腦(PC)新機售價在16年間下跌超過90%。
意想不到的是,大語言模型售價竟然在三年多內已經錄得同樣跌幅。a16z將這個現象戲稱為大型語言模型通縮(LLMflation)。
大語言模型的Token售價出現急跌,其實由多個原因導致。
首先,摩爾定律(Moore’s Law)發揮功效,
即是進一步壓縮GPU上的電晶體數目,令到GPU處理能力上升,進而降低每單位Token的生產成本。
此外,透過調整AI運算的精準度要求,以減低運算成本。以往要以16位元進行運算,要求極為精準,但卻耗用更多資源,令Token成本及售價高企。
然而,AI執行推論任務時,則容許以4位元為運算標準,Token當然有空間減價。
另一邊廂,中美AI競爭也是Token價格急跌的重要原因。OpenAI在2022年11月30日推出ChatGPT,在2023年3月14日Anthropic推出Claude,兩日後的2023年3月16日,內地也推出首個大語言模型。
字節跳動率先劈價
當時百度集團(09888)推出的文心一言模型,雖然較ChatGPT遲了三個多月時間,但內地AI前沿實驗室主動發動Token劈價戰,並由字節跳動打開劈價序幕。
字節跳動在2024年5月大幅調低其大語言模型豆包的Token售價,宣稱Token售價已經較行業便宜99.3%。
豆包用戶利用API輸入,每1,000個Token輸入AI系統的售價低至0.0008元人民幣,即1元人民幣在豆包買到125萬個Token。
阿里巴巴(09988)的通義千問,亦將Token售價大減97%;而百度及騰訊控股(00700)更曾把其主力模型或輕量級模型,免費開放予用戶使用。
內地大語言模型鬥平之餘,亦鬥表現,務求在模型性能上與美國一較高下。
美國優勢僅剩3%
根據彭博行業研究(Bloomberg Intelligence)引述AI權威基準測試平台LiveBench的數據,美國AI模型相較於內地模型的領先優勢,在今年出現顯著收窄的趨勢。
今年初美國AI模型的領先優勢尚多達15%;到了5月,該差距已縮減至9%。
踏入9月,隨著深度求索(DeepSeek)發布V4.1 Flash模型,美國的領先優勢,更進一步被壓縮至僅剩3%,創下歷史新低。
如上述趨勢持續,內地AI前沿模型的表現有機會反超前美國。屆時不但在Token售價上擁有較強定價權,內地模型甚至能夠在環球市場上取得更大的市場佔有率。